Tóm tắt nhanh
- Ngày 30/10/2026, Google, Microsoft và OpenAI cùng công bố sẽ đọc một tín hiệu chung trong tệp robots.txt: website ghi một nhóm lệnh để nói "không dùng nội dung của tôi để huấn luyện AI tạo sinh", thay vì viết riêng cho từng trình thu thập.
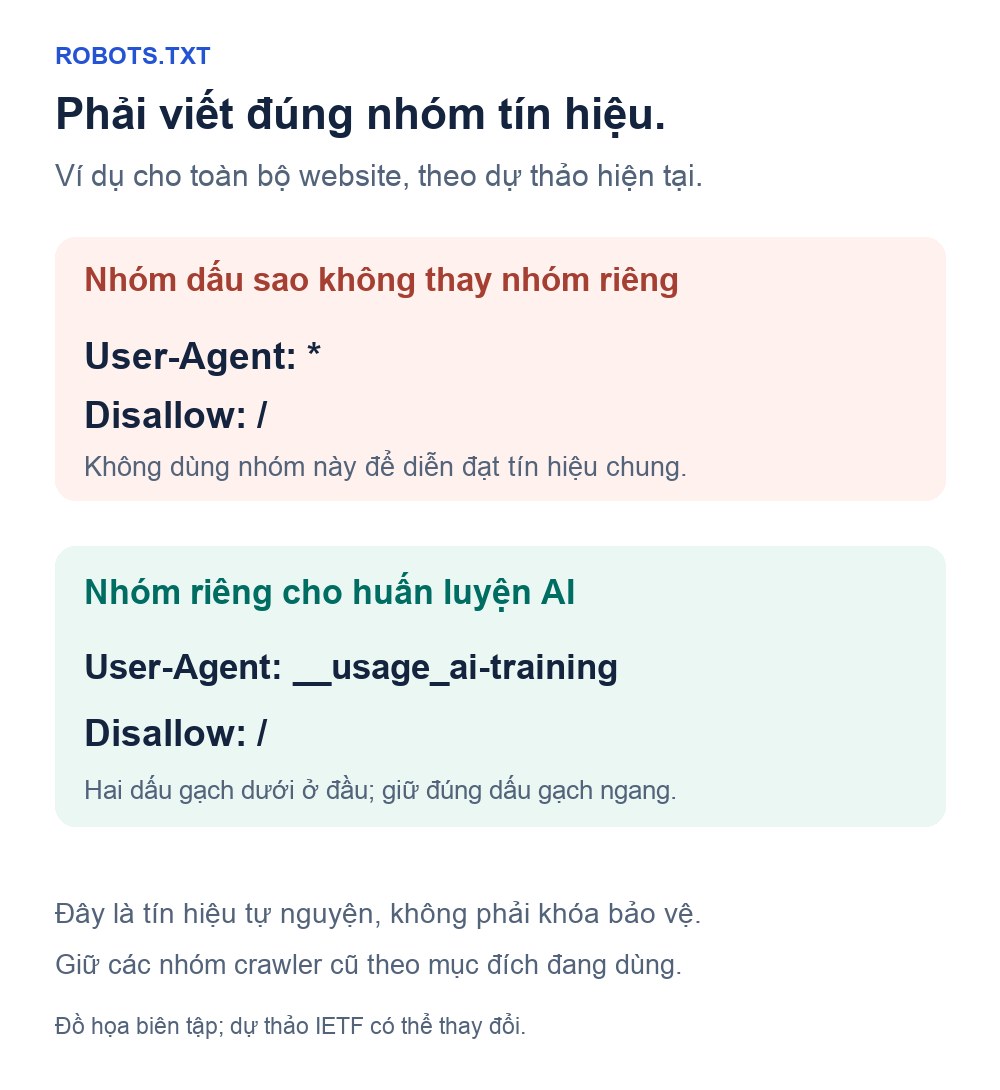
- Cú pháp theo dự thảo IETF và ví dụ của Microsoft là nhóm
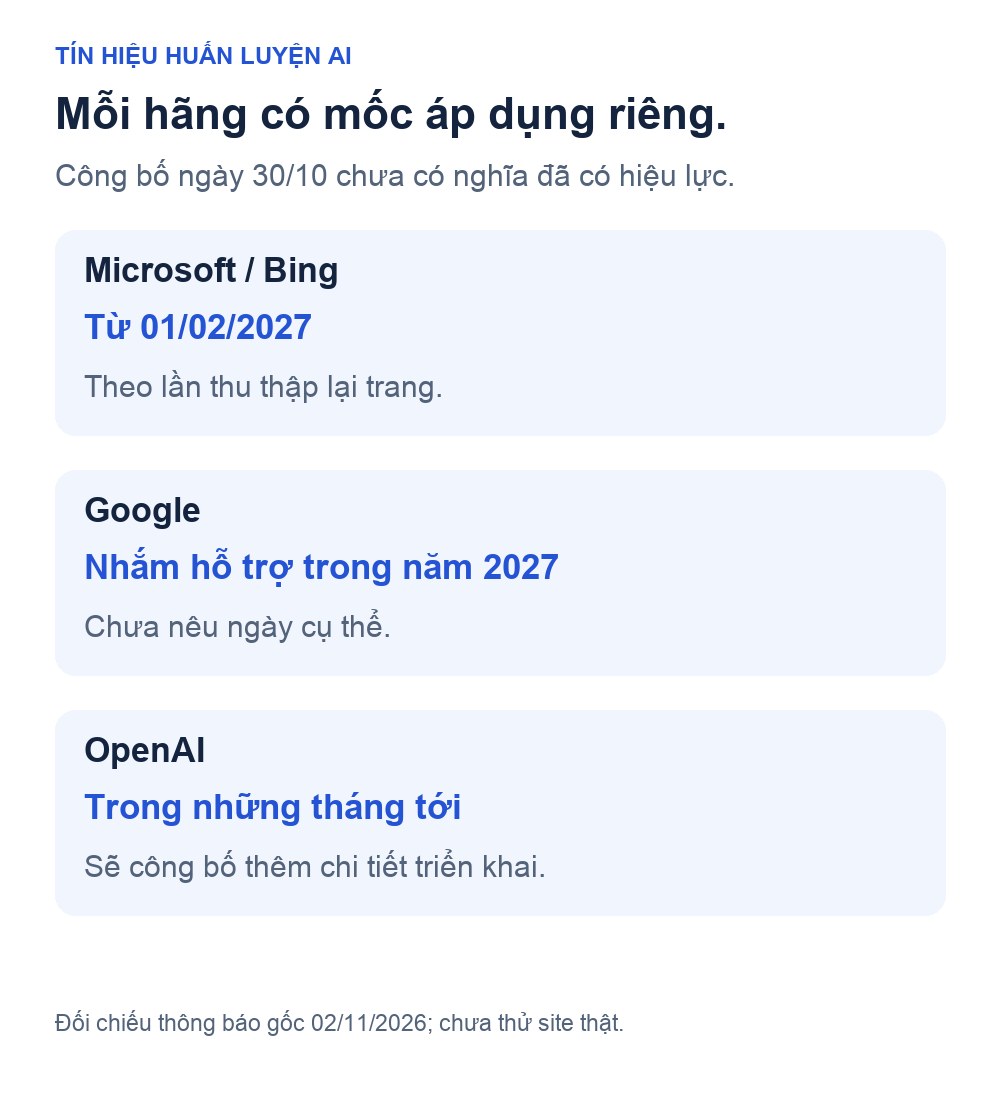
User-Agent: __usage_ai-trainingkèmDisallow. - Ba hãng trong bài đều nêu mốc triển khai về sau: Microsoft từ 01/02/2027; Google "nhắm hỗ trợ trong năm 2027"; OpenAI "trong những tháng tới".
- Từ chối huấn luyện không làm trang mất khỏi kết quả tìm kiếm thông thường. Microsoft nói rõ điều này với Bing.
- Đây là tín hiệu tự nguyện, không phải khóa kỹ thuật. Trình thu thập không tham gia vẫn có thể bỏ qua.
Vì sao chủ website nên biết?
Trước đây, muốn từ chối huấn luyện AI, bạn phải biết tên từng trình thu thập (ví dụ Google-Extended của Google, GPTBot của OpenAI) và viết mỗi hãng một nhóm. Danh sách đó dài thêm mỗi năm. Tín hiệu chung giúp một cửa hàng online, một trang tin nội bộ hay blog doanh nghiệp nói một lần cho mọi hãng tham gia.
Tín hiệu này dựa trên công việc của nhóm AI Preferences (AIPREF) tại IETF, tổ chức soạn chuẩn Internet. Bản mô tả hiện là dự thảo cá nhân (Internet-Draft) đăng ngày 30/10/2026, chưa được IETF chứng thực là tiêu chuẩn.
Viết thế nào?
Từ chối huấn luyện cho cả website:
User-Agent: __usage_ai-training
Disallow: /
Từ chối cho một thư mục, ví dụ kho tài liệu khách hàng, còn lại để mặc định:
User-Agent: __usage_ai-training
Disallow: /tai-lieu-khach-hang/
Từ chối cả website nhưng vẫn cho một thư mục, ví dụ trang báo chí (theo ví dụ trong dự thảo):
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Ba điều hay nhầm:
- Nhóm
User-Agent: *không được tính. Dự thảo ghi rõ nhóm dấu sao không được hiểu là khớp với token này, nên phải viết nhóm riêng. - Không có nhóm tín hiệu này nghĩa là bạn chưa nêu lựa chọn qua tín hiệu chung, theo dự thảo IETF. Riêng Microsoft nói mặc định là Allow nếu không có lựa chọn hạn chế. Đừng coi việc không khai là sự đồng ý rõ ràng của chủ website.
- Đây là tín hiệu về cách dùng nội dung, không phải lệnh cấm thu thập. Muốn chặn hẳn một trình thu thập vào trang thì vẫn dùng nhóm User-Agent theo tên bot như cũ.
Mỗi hãng nói gì, khi nào có hiệu lực?
| Hãng | Đã công bố (30/10/2026) | Mốc áp dụng | Cách riêng cũ |
|---|---|---|---|
| Microsoft (Bing, Copilot, Microsoft 365) | Đọc token chung trong robots.txt; thêm tùy chọn theo từng trang cho huấn luyện và cho grounding (dùng nội dung làm căn cứ trả lời); không đổi điều kiện hiện trên Bing | Từ 01/02/2027, khi Bing thu thập lại trang | NoArchive, NoCache thôi được đọc cho huấn luyện và grounding sau 01/03/2027 |
| Website dùng token để từ chối mà không khai Google-Extended thì Google coi như đã chặn Google-Extended | Google ghi "nhắm hỗ trợ trong năm 2027", chưa nêu ngày | Google-Extended vẫn chạy song song | |
| OpenAI | Sẽ tuân thủ tín hiệu chung | "Trong những tháng tới", sẽ công bố chi tiết sau | Các kiểm soát trình thu thập hiện có giữ nguyên |
Tổ Thạo Việc chưa thấy nguồn chính thức của các công ty AI khác về tín hiệu này lúc soạn bài (02/11/2026). Đừng giả định mọi hãng đều đọc.
Microsoft có thêm lựa chọn theo từng trang
Nếu bạn muốn chỉ một trang có thiết lập khác, Microsoft cho gắn thẻ meta hoặc tiêu đề HTTP:
<meta name="Bingbot" content="ai-training:disallow">
<meta name="Bingbot" content="ai-grounding:disallow">
ai-trainingtheo trang sẽ ghi đè thiết lập trong robots.txt cho trang đó.ai-groundingchỉ đặt được theo trang, không có bản cho cả site. Có ba mức: để mặc định (cho phép),disallowextended(chỉ cho các sản phẩm Microsoft tự vận hành dùng),disallow(không dùng làm căn cứ trả lời).- Microsoft cảnh báo: từ chối grounding sẽ làm thương hiệu ít xuất hiện trong câu trả lời AI. Với doanh nghiệp nhỏ muốn được AI nhắc tới, thường chỉ cân nhắc từ chối huấn luyện, giữ grounding.
- Nếu site đang dùng NoArchive hoặc NoCache: Microsoft yêu cầu đặt lại bằng thiết lập mới trước 01/03/2027 (grounding cần ghi thêm ở Bing Webmaster Tools, mở từ 15/12/2026).
Nên chặn hay không? Bốn câu hỏi
- Nội dung của bạn có giá trị riêng (bài chuyên môn, ảnh sản phẩm tự chụp, tài liệu hướng dẫn) mà bạn không muốn thành dữ liệu huấn luyện?
- Bạn có cần AI nhắc tên, dẫn link tới trang của mình không? Đó là grounding, tách với huấn luyện.
- Thư mục nào chứa tài liệu khách hàng, bảng giá nội bộ? Những thứ này không nên để công khai ngay từ đầu; robots.txt không phải lớp bảo vệ.
- Ai trong công ty sửa được robots.txt, và ai ghi lại lần sửa? Nếu thuê ngoài làm web, gửi họ đoạn mẫu ở trên và xin ảnh chụp tệp sau khi sửa.
Kiểm sau khi sửa
- Mở
https://ten-mien-cua-ban/robots.txttrên trình duyệt, xem nhóm__usage_ai-trainingđã hiện đúng chưa. - So chính tả: hai dấu gạch dưới ở đầu, gạch ngang giữa
aivàtraining. - Kiểm các nhóm cũ cho Googlebot, Bingbot vẫn nguyên, để không vô tình chặn tìm kiếm.
- Ghi ngày sửa. Tín hiệu chỉ có hiệu lực khi hãng đã áp dụng và đã thu thập lại trang.
- Đặt lịch xem lại đầu năm 2027, khi Google và OpenAI công bố cách triển khai.
Giới hạn của bài này
- Cú pháp lấy từ dự thảo IETF và ví dụ của Microsoft ngày 30/10/2026; dự thảo có thể đổi trước khi thành chuẩn.
- Theo thông báo của ba hãng được dẫn, các mốc áp dụng còn ở phía trước tại ngày đối chiếu 02/11/2026; Tổ Thạo Việc chưa thử trên website thật.
- robots.txt là lời ngỏ ý tự nguyện; không thay cho đăng nhập, phân quyền hay hợp đồng bản quyền.
- Bài không phải tư vấn pháp lý về bản quyền.
Nguồn
- Google Search Central Blog, Supporting a shared AI training control for websites, 30/10/2026: https://developers.google.com/search/blog/2026/10/ai-training-control
- Bing Blog, Your content, your choice: clearer preferences for training and grounding, 30/10/2026: https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
- OpenAI, Giúp các website dễ dàng thể hiện lựa chọn về việc huấn luyện AI, 30/10/2026: https://openai.com/vi-VN/index/helping-websites-express-ai-training-preferences/
- IETF Internet-Draft draft-kelley-aipref-training-preference-signal-00: https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
- Phát hiện ban đầu: bài Để AI Tính 01/11/2026.