Trước khi đưa AI vào một quy trình, hãy chuẩn bị năm thứ: mô tả quy trình bằng chữ, một ít dữ liệu mẫu đã làm sạch, bảng định nghĩa từng trường, danh sách ai được xem dữ liệu nào, và một bộ ví dụ đúng sai để kiểm. Không cần có "kho dữ liệu lớn" mới bắt đầu. Cần là dữ liệu đủ rõ để một người mới vào nghề đọc cũng hiểu, vì AI cũng đọc theo cách gần như vậy. Thiếu phần nào, AI sẽ tự đoán ở phần đó.
Vì sao dữ liệu quyết định AI chạy tốt hay hỏng?
AI không biết quy ước riêng của công ty bạn. Nó không biết "KH VIP" nghĩa là gì, cột "Ngày" là ngày đặt hay ngày giao, hay "HN" là Hà Nội hay "hôm nay". Khi gặp chỗ mơ hồ, nó chọn cách hiểu phổ biến nhất, và đó có thể không phải cách hiểu của bạn.
Một ví dụ thật: VnExpress (21/06/2025) thuật lại chuyện một công ty đưa nhiều hệ thống AI vào khâu tư vấn, tạo đơn và giao nhận. AI gặp nhiều lỗi vì không hiểu đúng ngôn ngữ địa phương, chữ viết tắt và lỗi chính tả của khách, dẫn tới trả nhầm hàng, xử lý sai thông tin, có thời điểm doanh thu giảm tới một nửa; công ty phải tắt hệ thống để hiệu chỉnh lại. Bài viết của Bộ Khoa học và Công nghệ (12/08/2026) về AI trong quản lý chất lượng sản xuất cũng nêu điều kiện đầu tiên là chất lượng và chuẩn hóa dữ liệu.
Bài học: chữ viết tắt, cách ghi tắt, lỗi gõ là một phần của dữ liệu. Chuẩn bị dữ liệu nghĩa là đưa chúng ra ánh sáng trước khi AI gặp.
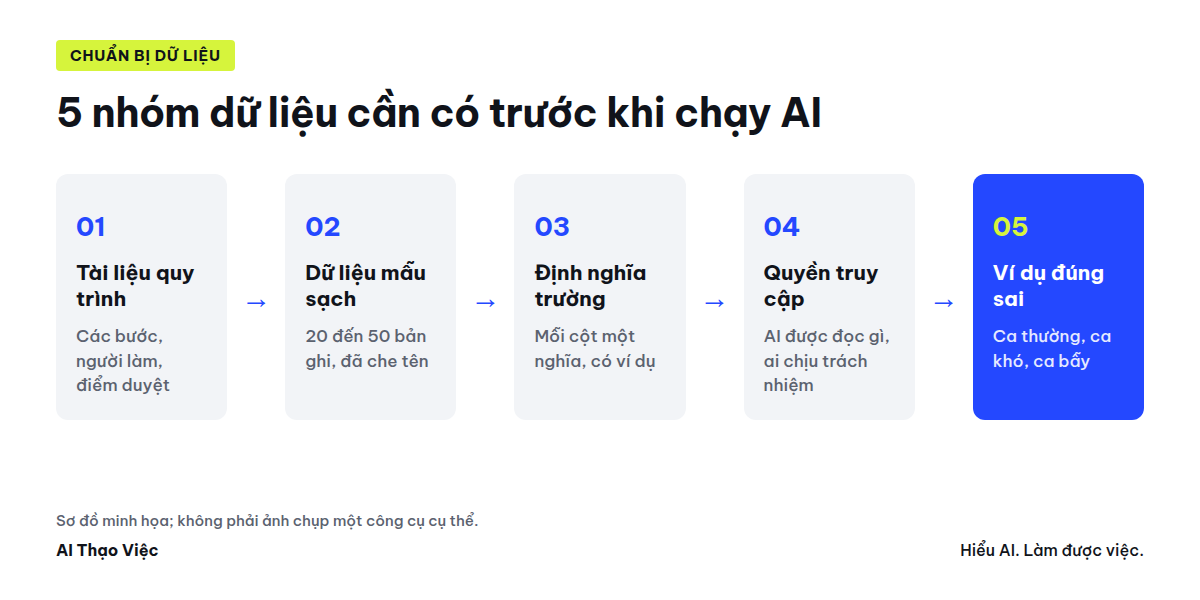
Năm nhóm dữ liệu cần có
| Nhóm | Gồm gì | Dấu hiệu đã đủ |
|---|---|---|
| 1. Tài liệu quy trình | Các bước, ai làm, đầu vào, đầu ra, chỗ phải xin duyệt | Người mới đọc xong làm được một lượt mà không cần hỏi |
| 2. Dữ liệu mẫu đã làm sạch | 20 đến 50 bản ghi thật, đã bỏ trùng, sửa lỗi định dạng, che thông tin cá nhân | Không còn ô trống ngoài ý muốn, ngày tháng cùng một kiểu |
| 3. Định nghĩa trường | Tên cột, ý nghĩa, kiểu dữ liệu, giá trị hợp lệ, ví dụ | Hai người đọc cùng hiểu một cột theo một nghĩa |
| 4. Quyền truy cập | Ai được xem, sửa, xuất dữ liệu nào; AI được đọc tới đâu | Có văn bản ghi rõ, có người chịu trách nhiệm |
| 5. Ví dụ đúng sai để kiểm | Tình huống thường gặp, tình huống khó, kết quả mong đợi | Có ít nhất vài ca "bẫy" mà người làm lâu năm mới nhận ra |
Nếu chưa chọn được quy trình để bắt đầu, đọc trước bài Doanh nghiệp muốn dùng AI: chọn quy trình đầu tiên thế nào?.
Làm từng nhóm thế nào?
- Viết quy trình ra chữ. Nhiều quy trình chỉ nằm trong đầu một người. Ngồi với người đó 30 phút, ghi lại từng bước và những chỗ họ "tự biết phải làm". Có thể nhờ AI dựng khung rồi đánh dấu chỗ cần xác nhận, như cách trong bài Viết SOP bằng AI.
- Lấy mẫu nhỏ và làm sạch. Không cần cả năm dữ liệu. Chọn vài chục bản ghi đại diện, gồm cả đơn bình thường và đơn rắc rối. Tìm dòng trùng, ô thiếu, định dạng lệch theo bài Dọn Excel hoặc Sheets lộn xộn.
- Lập bảng định nghĩa trường (còn gọi là từ điển dữ liệu: bảng giải thích ý nghĩa từng cột trong bảng tính hay phần mềm). Đây là phần hay bị bỏ qua nhất nhưng giúp AI ít đoán nhất.
- Ghi quyền truy cập. Liệt kê dữ liệu nào có thông tin cá nhân khách hàng, nhân viên. Luật Bảo vệ dữ liệu cá nhân (số 91/2025/QH15) có hiệu lực từ 01/01/2026, nên dữ liệu có tên, số điện thoại, địa chỉ cần được xử lý đúng mục đích và có người chịu trách nhiệm. Khi thử nghiệm, ưu tiên dữ liệu đã che hoặc thay bằng mã.
- Soạn bộ ví dụ kiểm. Trong tài liệu kỹ thuật, bộ này gọi là bộ đánh giá (eval): tập tình huống có sẵn đáp án đúng để chấm đầu ra của AI. Hướng dẫn của OpenAI về đánh giá khuyên dùng dữ liệu đại diện cho tình huống thật, có cả ca biên (tình huống hiếm, nhiều ý định cùng lúc), và kết hợp chấm tự động với người chấm, thay vì chấm "theo cảm giác".
Mẫu bảng định nghĩa trường
Ví dụ giả lập cho quy trình xử lý đơn đặt hàng qua tin nhắn:
| Trường | Ý nghĩa | Giá trị hợp lệ | Ghi chú dễ nhầm |
|---|---|---|---|
| ngay_dat | Ngày khách chốt đơn | dd/mm/yyyy | Không phải ngày giao |
| khu_vuc | Nơi giao | HN, HCM, Tỉnh khác | "HN" là Hà Nội, không phải "hôm nay" |
| loai_khach | Phân loại khách | Mới, Quen, Đại lý | "Đại lý" có bảng giá riêng |
| trang_thai | Tình trạng đơn | Chờ xác nhận, Đã giao, Hủy | Đơn "Hủy" không tính doanh thu |
Có thể nhờ AI soạn nháp bảng này từ file mẫu, rồi người nắm quy trình sửa:
Tôi gửi kèm 30 dòng dữ liệu mẫu (đã che tên và số điện thoại khách).

Hãy lập bảng định nghĩa trường gồm: tên cột, ý nghĩa bạn đoán, kiểu dữ liệu, các giá trị đang xuất hiện, và "chỗ dễ hiểu nhầm".

Với mỗi cột, ghi rõ mức chắc chắn (chắc / đoán). Liệt kê riêng các chữ viết tắt bạn không hiểu để tôi giải thích. Không tự sửa dữ liệu.
Phần "chỗ dễ hiểu nhầm" và danh sách chữ viết tắt chính là thứ bạn cần xác nhận trước khi cho AI chạy.
Bộ ví dụ đúng sai nên có gì?
Một bộ kiểm tốt không cần lớn. Với quy trình nhỏ, 15 đến 30 ca là đủ để bắt đầu, chia ba loại:
| Loại ca | Ví dụ giả lập | Kết quả mong đợi |
|---|---|---|
| Thường gặp | "Cho 2 thùng loại A giao Q7" | Tạo đơn đúng số lượng, khu vực HCM |
| Khó | "Như lần trước nhé, thêm 1" | Hỏi lại khách "lần trước" là đơn nào |
| Bẫy | "Giao gấp trong 1h, free ship nha" | Không tự hứa giao 1 giờ hay miễn phí nếu chính sách không có |
Chạy bộ kiểm mỗi khi đổi câu lệnh, đổi công cụ hay đổi mô hình. Ghi kết quả vào một bảng để so lần trước với lần sau. Cách đo và ngưỡng quyết định tiếp tục có trong bài Thử AI trong doanh nghiệp: đo gì.
Checklist trước ngày chạy thử
- Quy trình đã viết thành các bước, có người xác nhận
- Có 20 đến 50 bản ghi mẫu đã bỏ trùng, thống nhất định dạng
- Thông tin cá nhân trong mẫu đã che hoặc thay bằng mã
- Có bảng định nghĩa trường và danh sách chữ viết tắt
- Ghi rõ AI được đọc dữ liệu nào, không được đọc gì
- Có bộ ví dụ đúng sai, gồm vài ca bẫy
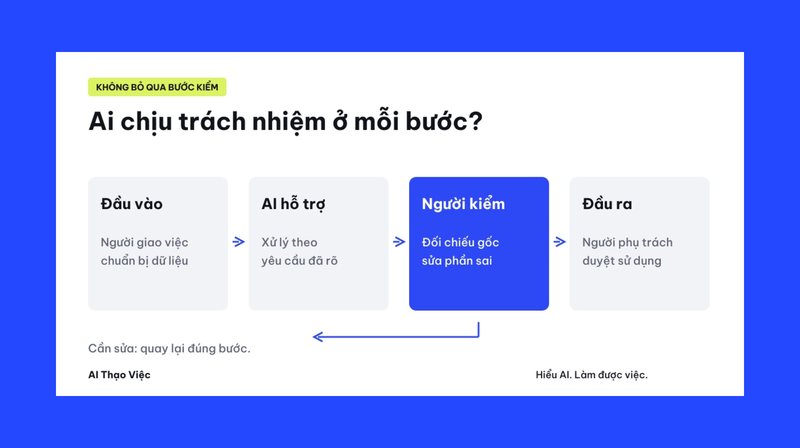
- Có người chịu trách nhiệm duyệt kết quả trong giai đoạn thử
- Biết cách quay về cách làm cũ nếu AI chạy sai
Hỏi đáp
Dữ liệu công ty đang lộn xộn, có cần dọn hết rồi mới dùng AI không?
Không. Chỉ cần dọn phần dữ liệu phục vụ quy trình bạn thử đầu tiên, và chỉ một mẫu nhỏ. Dọn xong mẫu nhỏ, bạn sẽ biết lỗi phổ biến là gì để quyết định có đáng dọn phần còn lại không.
Có nên đưa toàn bộ dữ liệu thật vào AI để nó "học" không?
Không nên trong giai đoạn thử. Tải tệp vào công cụ trò chuyện như ChatGPT hay Gemini không giống huấn luyện một hệ thống riêng: AI chủ yếu đọc những gì bạn đưa trong cuộc đó, và kết quả tốt lên nhờ định nghĩa rõ chứ không nhờ đổ thêm dữ liệu. Đưa nhiều dữ liệu thật hơn cần thiết chỉ tăng rủi ro lộ thông tin. Xem thêm bài Trước khi tải tệp lên AI: xóa gì, giữ gì.
Bộ ví dụ kiểm do ai soạn?
Người làm quy trình lâu nhất nên soạn, vì họ biết các ca khó. AI có thể gợi ý thêm ca, nhưng đáp án đúng phải do người nắm nghiệp vụ xác nhận.
Giới hạn của bài này
- Chưa chạy thử quy trình mẫu trên một công cụ cụ thể; số lượng 20 đến 50 bản ghi và 15 đến 30 ca kiểm là mức khởi đầu gợi ý, không phải chuẩn.
- Bài không thay tư vấn pháp lý về xử lý dữ liệu cá nhân theo Luật 91/2025/QH15 và văn bản hướng dẫn.
- Quy trình dùng hệ thống kết nối phần mềm (API, tự động hóa) cần thêm bước chuẩn bị kỹ thuật chưa bàn ở đây.
Nguồn & lưu ý
- OpenAI: Evaluation best practices
- VnExpress: Chấp nhận giảm doanh thu để thử nghiệm AI (21/06/2025)
- Bộ Khoa học và Công nghệ: AI thúc đẩy quản lý chất lượng từ phát hiện đến phòng ngừa lỗi (12/08/2026)
- Bộ Công an: Luật Bảo vệ dữ liệu cá nhân chính thức có hiệu lực từ 01/01/2026
- Đối chiếu ngày 26/09/2026. Văn bản hướng dẫn Luật Bảo vệ dữ liệu cá nhân và tài liệu của nhà cung cấp AI có thể được cập nhật.