Mô hình ngôn ngữ lớn (LLM, large language model) là phần "bộ não" bên trong ChatGPT, Gemini, Claude hay Copilot: một chương trình đã học từ lượng văn bản rất lớn để đoán chữ tiếp theo hợp lý nhất. Nhờ đoán rất giỏi, nó viết được email, tóm tắt báo cáo, dịch tài liệu. Nhưng vì là đoán, nó có thể viết trôi chảy mà vẫn sai. Hiểu bốn khái niệm dưới đây giúp bạn biết khi nào nên tin, khi nào phải kiểm.
Mô hình ngôn ngữ lớn hoạt động thế nào, nói gọn?
Tài liệu nhập môn của Google định nghĩa mô hình ngôn ngữ là mô hình ước tính khả năng một đơn vị chữ, hoặc chuỗi đơn vị chữ, xuất hiện trong một đoạn văn dài hơn. Nói theo cách đời thường: bạn gõ "Kính gửi anh chị, em xin phép", mô hình tính xem chữ nào hay đi tiếp nhất trong hàng triệu email nó đã học, rồi viết tiếp từng chút một.
"Lớn" nghĩa là mô hình học từ rất nhiều văn bản và có rất nhiều tham số (các con số bên trong ghi lại quy luật ngôn ngữ). Quy mô đó giúp nó làm được việc nó chưa từng được dạy riêng, như viết lại một điều khoản hợp đồng cho dễ hiểu.
Hệ quả cho người đi làm: mô hình không "tra" sự thật như công cụ tìm kiếm. Nó tạo ra câu nghe hợp lý. Trang trợ giúp của OpenAI ghi rõ ChatGPT có thể đưa thông tin sai, kể cả trích dẫn bịa và ngày tháng sai, trong khi giọng văn vẫn chắc chắn.
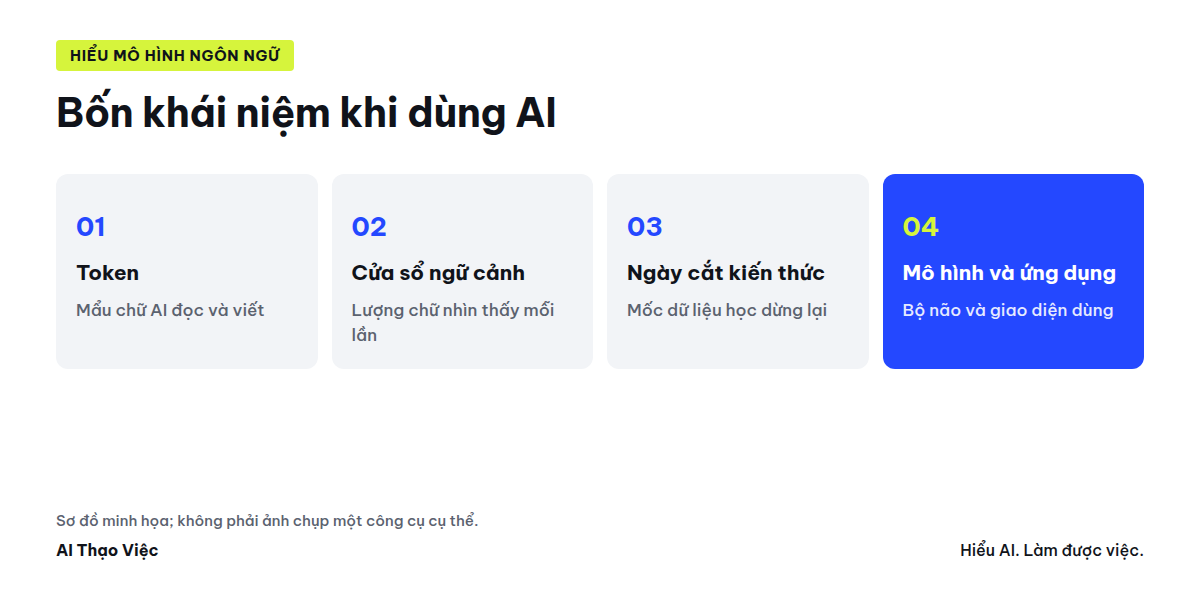
Bốn khái niệm cần biết, kèm ví dụ công việc
| Khái niệm | Nghĩa ngắn | Ví dụ khi làm việc |
|---|---|---|
| Token | Đơn vị chữ mà mô hình xử lý | Tài liệu dài tốn nhiều token, dễ hết lượt dùng |
| Cửa sổ ngữ cảnh | Lượng chữ mô hình "nhìn thấy" trong một lần trả lời | Cuộc trò chuyện quá dài, AI quên chỉ dẫn ban đầu |
| Ngày cắt kiến thức | Mốc thời gian dữ liệu học của mô hình dừng lại | AI không biết thông tư mới ban hành |
| Mô hình và ứng dụng | Mô hình là bộ não; ứng dụng là giao diện bạn dùng | Cùng tên ChatGPT nhưng mô hình bên trong thay đổi |
Token
Token là mẩu chữ nhỏ mà mô hình đọc và viết: có thể là một chữ cái, một phần của từ, cả một từ hoặc dấu câu. OpenAI ước tính với tiếng Anh, một token khoảng 4 ký tự, tức khoảng ba phần tư một từ, và lưu ý ngôn ngữ khác có tỷ lệ khác. Với tiếng Việt, bài này không nêu tỷ lệ vì mỗi mô hình chia chữ một kiểu; nếu cần con số, dùng công cụ đếm token của chính nhà cung cấp.
Vì sao bạn cần quan tâm: hạn mức dùng trong gói chat và giá khi dùng qua API đều liên quan đến token. Gửi nguyên báo cáo 80 trang để hỏi một câu là tốn nhiều hơn gửi đúng chương cần. Bài Hết lượt dùng AI giữa buổi có sáu cách chia việc cho đỡ tốn.
Cửa sổ ngữ cảnh
Cửa sổ ngữ cảnh là toàn bộ chữ mà mô hình có thể tham chiếu khi trả lời, gồm tin nhắn của bạn, tài liệu đính kèm, lịch sử trò chuyện và cả câu trả lời nó đang viết. Tài liệu của Anthropic gọi đây là "bộ nhớ làm việc" của mô hình, khác với lượng dữ liệu nó đã học. Theo tài liệu này, các mô hình Claude hiện có cửa sổ 200 nghìn hoặc 1 triệu token tùy mô hình.
Ví dụ công việc: bạn trao đổi cả buổi sáng trong một cuộc trò chuyện, đổi qua ba việc. Đến chiều, AI bắt đầu lẫn chi tiết việc này với việc kia hoặc bỏ qua quy tắc bạn đặt từ đầu. Cách xử lý đơn giản là mỗi việc một cuộc trò chuyện.
Ngày cắt kiến thức
Mô hình học từ dữ liệu đến một mốc nhất định rồi dừng. Sau mốc đó, nó không biết gì mới nếu ứng dụng không cho nó tra web hoặc bạn không đưa tài liệu vào. Trang tổng quan mô hình của Anthropic công khai mốc này cho từng mô hình (cột Reliable knowledge cutoff), và các mô hình khác nhau có mốc khác nhau, cách nhau cả năm.
Ví dụ công việc: bạn hỏi "chế độ kế toán doanh nghiệp theo thông tư nào?". Nếu văn bản mới ban hành sau ngày cắt kiến thức, mô hình có thể trả lời theo văn bản cũ, rất tự tin. Với luật, giá, tính năng sản phẩm, luôn yêu cầu AI tra nguồn hoặc tự dán văn bản gốc vào.
Mô hình và ứng dụng: GPT khác ChatGPT thế nào?
Mô hình là phần lõi, được đặt tên theo phiên bản (dòng GPT của OpenAI, dòng Gemini của Google, dòng Claude của Anthropic). Ứng dụng là thứ bạn mở ra dùng: ChatGPT, ứng dụng Gemini, Claude, Copilot. Ứng dụng thêm vào mô hình những thứ như lịch sử trò chuyện, tải tệp, tìm web, bộ nhớ, và thường cho chọn giữa nhiều mô hình.
Hai hệ quả thực tế. Thứ nhất, cùng là "ChatGPT" nhưng mô hình bên trong đổi theo thời gian và theo gói, nên câu trả lời hôm nay có thể khác tháng trước. Thứ hai, doanh nghiệp có thể gọi thẳng mô hình qua API (cổng để phần mềm khác kết nối) mà không cần ứng dụng chat; OpenAI ghi rõ API tính phí riêng, tách khỏi gói ChatGPT Plus hay Business.
Áp dụng: ba thói quen rút ra từ bốn khái niệm
- Đưa đúng tài liệu cần, không đưa cả thư mục. Tiết kiệm token và giữ cửa sổ ngữ cảnh gọn.
- Mở cuộc mới khi đổi việc. Tránh việc chỉ dẫn cũ bị trôi khỏi cửa sổ ngữ cảnh.
- Hỏi thông tin mới thì bật tìm web hoặc tự dán nguồn. Rồi mở link kiểm, vì mô hình vẫn có thể tóm sai.
Trước khi trả lời, cho tôi biết:
1. Câu trả lời dựa trên tài liệu tôi gửi, trên kết quả tìm web, hay trên kiến thức sẵn có của bạn?
2. Nếu dựa trên kiến thức sẵn có, thông tin này có thể đã thay đổi sau ngày cắt kiến thức của bạn không?

Câu hỏi: [câu hỏi của bạn]
Hỏi đáp
Mô hình ngôn ngữ lớn có "hiểu" như người không?
Nó xử lý quy luật ngôn ngữ rất tốt nên trông như hiểu, nhưng không có trải nghiệm hay kiểm chứng thực tế như người. Với công việc, cách an toàn là coi đầu ra là bản nháp của một người viết nhanh, cần người có chuyên môn kiểm.
AI có học từ dữ liệu tôi gõ vào không?
Tùy nhà cung cấp, gói và cài đặt. Gói cá nhân thường có tùy chọn cho phép hoặc không cho dùng dữ liệu để cải thiện mô hình. Với API, OpenAI và Anthropic cho biết mặc định không dùng dữ liệu để huấn luyện, còn bậc miễn phí của Gemini API thì có dùng; chi tiết trong bài API của AI là gì. Xem mục quyền riêng tư trong cài đặt của công cụ bạn dùng.
Mô hình mới hơn có luôn tốt hơn không?
Thường mạnh hơn ở việc khó, nhưng có thể tốn lượt hơn và chậm hơn. Việc đơn giản như sửa chính tả, đổi giọng email thì mô hình nhẹ đủ dùng.
Giới hạn của bài này
- Bài giải thích ở mức người dùng, bỏ qua cách huấn luyện và kiến trúc mô hình.
- Con số cửa sổ ngữ cảnh chỉ lấy từ tài liệu Anthropic; OpenAI và Google công bố riêng cho từng mô hình và thay đổi thường xuyên.
- Chưa đo số token thực tế của văn bản tiếng Việt trên từng mô hình.
Nguồn & lưu ý
- Google for Developers: Introduction to Large Language Models
- OpenAI Help Center: What are tokens and how to count them?
- OpenAI Help Center: Does ChatGPT tell the truth?
- OpenAI: API Pricing
- Anthropic Claude Docs: Context windows
- Anthropic Claude Docs: Models overview
- Đối chiếu ngày 26/09/2026. Kích thước cửa sổ ngữ cảnh và ngày cắt kiến thức thay đổi theo từng phiên bản mô hình.