Model mới chỉ đáng đổi khi nó làm tốt hơn đúng việc bạn hay giao cho AI, trong đúng gói bạn đang dùng. Cách biết là tự thử: cùng một việc, cùng đầu vào, cùng tiêu chí viết sẵn, chạy trên cả model cũ và mới, rồi so số lỗi, số lần phải sửa và thời gian.
Model (mô hình AI) là phần "bộ não" phía sau ChatGPT, Gemini, Claude hay Copilot. Mỗi lần hãng ra model mới, thông cáo thường kèm bảng điểm trên các bài đo chuẩn (benchmark: bộ câu hỏi hoặc bài tập cố định dùng để chấm model). Những con số đó cho biết hãng đã cải tiến theo hướng nào, nhưng không cho biết bản tóm tắt biên bản họp bằng tiếng Việt của bạn sẽ ít lỗi hơn bao nhiêu. Bài này là cách tự trả lời câu đó trong khoảng một giờ.
Tài liệu hãng nói được gì, phép thử của bạn nói được gì?
| Câu hỏi | Tài liệu của hãng | Phép thử của bạn |
|---|---|---|
| Model có trong gói nào, khu vực nào, giá bao nhiêu | Nguồn chính, đọc trước | Kiểm lại bộ chọn trên đúng tài khoản |
| Điểm trên bài đo chuẩn | Có, do hãng chọn bài đo và cách chạy | Không trả lời |
| "Nhanh hơn, rẻ hơn X%" | Có, thường là trung bình trên việc của hãng | Thời gian thật trên việc của bạn |
| Việc tiếng Việt của bạn có ít lỗi hơn không | Không | Có |
| Bạn có phải sửa tay ít hơn không | Không | Có |
Ví dụ: khi ra mắt Claude Sonnet 5.5 ngày 28/09/2026, Anthropic công bố model này nhanh hơn trên 30% và rẻ hơn tới 30% cho phần lớn việc so với Sonnet 5. Đó là công bố của hãng, nên viết đúng là "Anthropic nói", không phải "Sonnet 5.5 nhanh hơn 30%". Chi tiết trong bài Claude Sonnet 5.5: nên thử lại việc nào trước khi đổi?.
Chính tài liệu dành cho nhà phát triển của OpenAI và Anthropic cũng khuyên như vậy: đánh giá model bằng bài thử giống việc thật, đặt tiêu chí cụ thể và đo được trước khi chạy, không dựa vào thước đo chung chung, và so lại mỗi khi đổi model. Dưới đây là phiên bản rút gọn cho người dùng ứng dụng chat.
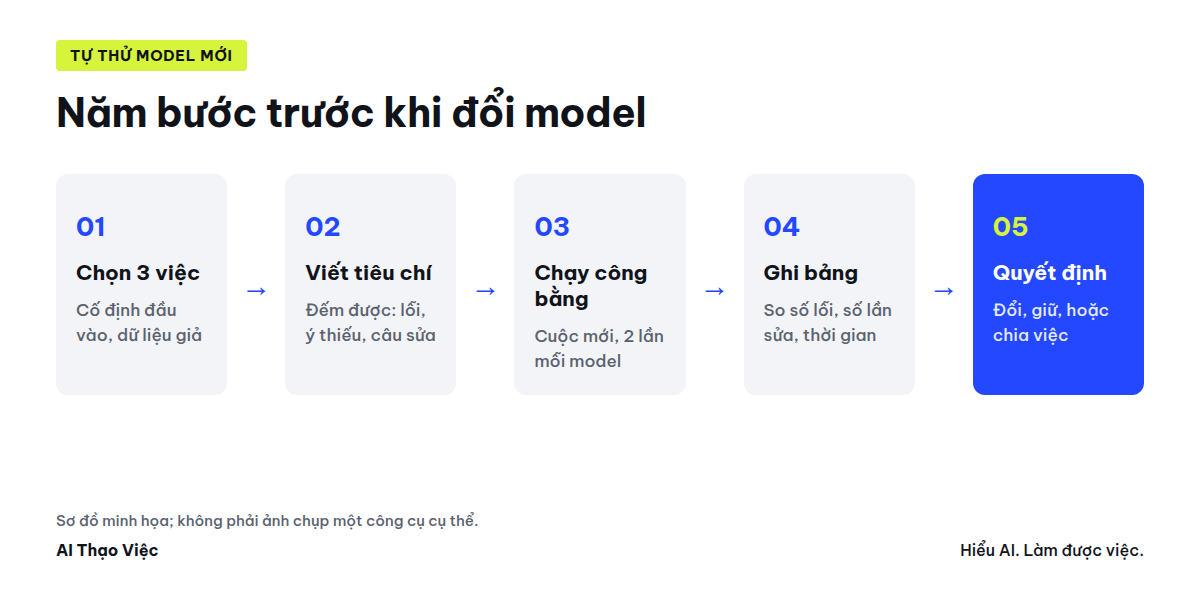
Bước 1. Chọn ba việc và cố định đầu vào
- Chọn ba việc bạn giao AI nhiều nhất trong tuần, mỗi việc một kiểu: ví dụ tóm tắt tài liệu thành bảng đầu việc, viết lại email theo giọng của bạn, lập bảng từ dữ liệu dán vào.
- Dùng tài liệu giả hoặc đã xóa tên khách hàng, số tiền, số điện thoại. Không dùng dữ liệu thật chỉ để thử.
- Lưu đầu vào và câu lệnh vào một tệp. Từ giờ đến lúc thử xong, không sửa một chữ nào.
- Với mỗi việc, ghi trước "đầu ra đạt" trông thế nào. Ví dụ: bảng đầu việc phải có đủ 6 việc trong biên bản, đúng tên người phụ trách, đúng hạn.
Bước 2. Viết tiêu chí chấm trước khi chạy
Tiêu chí phải đếm được hoặc trả lời được có hay không. "Viết hay hơn" không phải tiêu chí; "số câu phải sửa tay" là tiêu chí.
| Tiêu chí | Cách đo | Mức quan trọng |
|---|---|---|
| Sai dữ kiện so với đầu vào | Đếm số chỗ sai số, sai tên, sai ngày | Cao nhất: một lỗi số liệu nặng hơn năm câu văn đẹp |
| Tự thêm thông tin không có trong đầu vào | Đếm số chỗ | Cao |
| Đủ ý bắt buộc | Số ý có trên tổng số ý đã ghi ở Bước 1 | Cao |
| Đúng định dạng yêu cầu | Có / không | Vừa |
| Tiếng Việt tự nhiên, đúng thuật ngữ nhóm dùng | Số câu phải sửa tay | Vừa |
| Thời gian từ lúc gửi đến lúc dùng được | Phút, gồm cả thời gian chờ và sửa | Tùy việc |
Bước 3. Chạy cho công bằng
- Mỗi lần thử một cuộc trò chuyện mới, để lần trước không ảnh hưởng lần sau.
- Giữ nguyên mọi thứ trừ model: cùng công cụ, cùng tài khoản, tìm web cùng bật hoặc cùng tắt, bộ nhớ và hướng dẫn cá nhân giống nhau.
- Ghi mức suy nghĩ (ví dụ Instant hay High trong ChatGPT, mức nỗ lực trong Claude). Nếu hai model có mức mặc định khác nhau, hãy thử cả "mặc định với mặc định" vì đó là thứ bạn sẽ dùng hằng ngày.
- Chạy mỗi việc ít nhất hai lần cho mỗi model. AI không trả lời giống hệt nhau mỗi lần; một lần tốt hoặc tệ có thể là may rủi.
- Kiểm model thật sự đang chạy. Khi hết hạn mức, một số công cụ tự chuyển sang model khác; OpenAI ghi rõ ChatGPT có thể làm vậy. Nhìn nhãn trên giao diện trước khi ghi kết quả.
Bước 4. Ghi bảng kết quả
Ví dụ giả lập, không phải kết quả thử trên model nào. Việc: tóm tắt biên bản họp 8 trang thành bảng đầu việc, có 6 việc bắt buộc; mỗi ô là trung bình hai lần chạy.
| Tiêu chí | Model đang dùng | Model mới |
|---|---|---|
| Sai dữ kiện | 1 (sai hạn một việc) | 0 |
| Tự thêm thông tin | 0 | 0 |
| Đủ ý bắt buộc | 5/6 | 6/6 |
| Số câu sửa tay | 3 | 1 |
| Thời gian đến khi dùng được | 4 phút | 3 phút (chờ lâu hơn nhưng sửa ít hơn) |
Cách đọc ví dụ này: model mới chờ lâu hơn nhưng ít lỗi và ít sửa hơn, nên tổng thời gian vẫn giảm. Với việc này, đổi là hợp lý. Hai việc còn lại có thể cho kết quả ngược lại; hãy ghi đủ cả ba trước khi kết luận.
Muốn AI hỗ trợ soi lỗi dữ kiện, dùng câu lệnh dưới đây trong một cuộc trò chuyện mới. AI chỉ liệt kê chỗ nghi ngờ; bạn vẫn tự mở đầu vào để xác nhận từng chỗ và tự chấm điểm.
Dưới đây là ĐẦU VÀO và hai ĐẦU RA (A và B) do hai model AI tạo từ cùng đầu vào.
Không chọn bản nào hay hơn. Chỉ làm hai việc:
1. Với mỗi đầu ra, liệt kê mọi con số, tên người, ngày tháng khác với đầu vào, kèm câu gốc trong đầu vào.
2. Với mỗi đầu ra, liệt kê thông tin không có trong đầu vào.
Nếu không chắc, ghi "cần người kiểm".

ĐẦU VÀO:
[dán]

ĐẦU RA A:
[dán]

ĐẦU RA B:
[dán]
Bước 5. Quyết định: đổi, giữ hay chia việc
- Đổi cho việc đó khi model mới không sai dữ kiện nhiều hơn, đủ ý bằng hoặc hơn, sửa tay ít hơn, và vẫn nằm trong hạn mức của gói.
- Giữ model cũ nếu model mới sai dữ kiện nhiều hơn ở bất kỳ lần chạy nào, dù văn hay hơn.
- Chia việc khi mỗi model mạnh một việc: bản nhanh cho việc nhẹ, bản suy nghĩ lâu cho việc có số liệu. Bài Chọn model AI cho việc nào và đổi ở đâu? chỉ chỗ đổi trong từng công cụ.
- Tính cả chi phí: nếu model mới chỉ có ở gói cao hơn, so phần thời gian tiết kiệm với tiền nâng gói cả năm, không chỉ giá tháng.
- Chưa rõ thì chờ: giữ cách làm hiện tại, thử lại sau một đến hai tuần. Model mới thường được hãng triển khai dần.
Cho nhóm hoặc người dùng API
Nếu cả nhóm dùng chung một cách làm, hoặc phần mềm của bạn gọi AI qua API (cổng để phần mềm khác kết nối, tính phí theo lượng dùng), hãy giữ một bộ thử cố định khoảng 10 đến 20 mẫu việc thật đã xóa thông tin nhạy cảm, kèm đầu ra đạt. Mỗi lần có model mới, chạy lại đúng bộ đó và so cả chất lượng lẫn chi phí thực tế. Người quyết định đổi nên là người hiểu việc, không chỉ người phụ trách công cụ.
Theo dõi model mới thế nào cho đỡ mệt?
Không cần thử mọi bản mới. Chỉ mở lại bộ thử khi có ít nhất một trong ba dấu hiệu:
- Model mới xuất hiện trong bộ chọn của gói bạn đang dùng.
- Hãng nói rõ cải thiện đúng loại việc bạn làm (ví dụ bảng tính, tài liệu dài), không chỉ "thông minh hơn".
- Cách làm hiện tại đang có điểm nghẽn: hay sai, hay hết lượt, hoặc model đang dùng sắp bị hãng ngừng.
Khi một thay đổi về model làm khác cách làm của cả một nhóm công việc, AI Thạo Việc sẽ nhắc trong bài theo dõi Công việc nào dễ bị AI làm thay nhất?. Không phải kỳ nào cũng có mục về model; chỉ khi có thay đổi đáng kể với việc thật.
Kiểm trước khi đổi model
- Đã thử đủ ba việc, mỗi việc ít nhất hai lần cho mỗi model, cùng đầu vào.
- Đã ghi tiêu chí trước khi chạy, không sửa tiêu chí sau khi thấy kết quả.
- Đã xác nhận đúng model trên giao diện ở từng lần chạy.
- Không dùng dữ liệu khách hàng thật để thử.
- Với tài khoản công ty: model mới được quản trị viên cho phép và chính sách dữ liệu áp dụng như model cũ.
- Khi kể kết quả cho người khác, tách rõ "hãng công bố" với "mình đã thử trên việc X, ngày Y".
Hỏi đáp
Điểm benchmark cao hơn có nghĩa là model tốt hơn cho tôi không?
Không chắc. Bài đo chuẩn thường dùng tiếng Anh và việc như lập trình, toán, khác với email hay báo cáo tiếng Việt của bạn. Điểm cao là lý do để thử, không phải lý do để đổi ngay.
Thử bao nhiêu lần là đủ?
Với một người: ba việc, mỗi việc hai lần cho mỗi model là mức tối thiểu để bớt may rủi. Với nhóm hoặc phần mềm dùng API: bộ thử 10 đến 20 mẫu. Đây là phép thử để ra quyết định trong công việc, không phải nghiên cứu khoa học.
Có nên nhờ chính AI chấm xem bản nào hay hơn?
Chỉ nên nhờ AI liệt kê chỗ khác với đầu vào, như câu lệnh ở Bước 4. Người hiểu việc vẫn phải tự xác nhận và quyết định; tài liệu của OpenAI cũng khuyên dùng đánh giá của người để kiểm lại cách chấm tự động.
Tôi dùng gói miễn phí, có cần làm không?
Gói miễn phí thường ít lựa chọn model và model mặc định do hãng đặt. Phép thử vẫn có ích khi bạn cân nhắc trả tiền để dùng model cao hơn: thử trước bằng lượt dùng thử hoặc một tháng, rồi mới mua cả năm.
Giới hạn của bài này
- Đây là phép thử quy mô nhỏ để ra quyết định cá nhân hoặc trong nhóm, không thay được đánh giá bài bản khi AI dùng cho việc rủi ro cao.
- Bảng kết quả trong bài là ví dụ giả lập, không phải kết quả so sánh hai model cụ thể.
- Nguyên tắc đánh giá lấy từ tài liệu dành cho nhà phát triển của OpenAI và Anthropic, được rút gọn cho người dùng ứng dụng chat.
Nguồn & lưu ý
- OpenAI API Docs: Evaluation best practices
- Claude Platform Docs: Define success criteria and build evaluations
- Anthropic: Claude Sonnet 5.5, 28/09/2026 (ví dụ số liệu do hãng công bố)
- OpenAI Help Center: GPT-5.6 and GPT-6 Pro in ChatGPT (tự chuyển model khi hết hạn mức)
- Đối chiếu ngày 29/09/2026.